

OpenAI Unveils GPT-6.1 Terra…API Price Cut by 50%
 Published2026.10.27 16:11
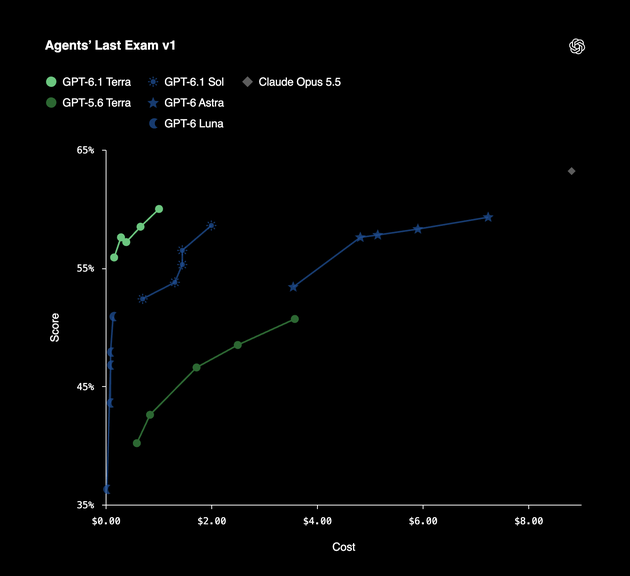
표준 API 가격은 GPT-5.6 테라·GPT-6.1 솔 대비 50% 낮게 책정됐으며, 챗GPT 워크(ChatGPT Work)와 코덱스(Codex), 오픈AI API를 통해 이용할 수 있다.
토큰 100만 개당 입력 1달러, 캐시된 입력 0.05달러, 출력 5달러가 적용된다.
작업당 비용은 전작의 약 3분의 1 수준이었다.
GPT-6 아스트라와 비교하면 토큰당 가격이 10분의 1 수준이면서 유사한 성능을 보였다고 오픈AI는 밝혔다.
시각적 추론 평가인 MMMU-Pro에서는 모든 추론 설정에서 GPT-5.6 테라를 앞섰으며, 데스크톱 다단계 작업 평가인 OSWorld 2.1에서도 중간 추론 수준으로 전작의 최고 점수를 넘어섰다.
다만 오픈AI는 가장 복잡한 코딩 작업에는 GPT-6.1 솔과 GPT-6 아스트라가 더 적합하다고 설명했다.
오류 유도 질문으로 구성된 내부 평가에서 추론 수준을 낮게 설정했을 때 GPT-6.1 테라의 오류율은 16.7%로, GPT-5.6 테라의 53.6%보다 약 37%포인트 낮았다.
최대 추론 수준에서는 4.3%를 기록했다.
GPT-6 아스트라에 적용된 안전장치를 동일하게 적용했으며, 악성 지시를 통한 프롬프트 인젝션 시험에서도 높은 저항성을 나타냈다고 덧붙였다.
GPT-6.1 테라는 챗GPT 워크·코덱스의 플러스·프로·엔터프라이즈·에듀 이용자와 오픈AI API 개발자(모델명: gpt-6.1-terra)에게 제공된다.
Comments
Related news
OpenAI Expands GPT-6 to All ChatGPT Users, Introduces 'Intelligent UI'
OpenAI has expanded GPT-6 to all ChatGPT subscription tiers and introduced 'Intelligent UI,' which dynamically changes response layouts in real-time based on question types. The rollout will be provided sequentially starting from the 8th to over 1.2 billion users, with web search response speeds improved by 44%. This next-generation user experience technology enhances information delivery methods by strategically combining visual elements such as maps, charts, and buttons according to context.
2026.10.08by 배종인 기자
Arm Announces CPU Benchmarking Methodology for Agentic AI
Arm has announced a CPU performance evaluation methodology specialized for agentic AI workloads. Developed with support from Fujitsu, Meta, and OpenAI, this methodology focuses on performance measurement based on actual agent task completion results. According to independent verification by Signal65, the Arm AGI CPU demonstrated an average performance advantage of 1.99x per rack compared to AMD EPYC Turin, with performance differences of 1.7x to 2.2x particularly in the tooling, orchestration, and inference domains.
2026.10.15by 배종인 기자
OpenAI upgrades ChatGPT voice features…adds 2 Korean language voices
OpenAI has upgraded ChatGPT's voice capabilities to GPT-Live-1.1, improving Korean language voice quality. Two new Korean-exclusive voices—the male voice 'Hanul' and the female voice 'Haetsal'—have been added, and natural conversational expressions during search waits have been enhanced. With full duplex technology, users and AI can converse simultaneously, and the feature is immediately available to free users as well.
2026.10.16by 배종인 기자
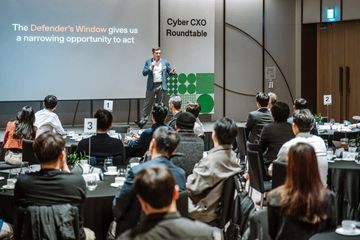
OpenAI shares AI cybersecurity defense strategy with domestic corporate CISOs
OpenAI introduced AI-based cybersecurity defense strategies to approximately 60 CISOs from domestic companies. The company presented an approach that automates the entire process from vulnerability discovery to remediation using integrated defense solutions Daybreak and Defense Factory while maintaining human oversight. The message emphasized that cybersecurity in the AI era should be treated as a critical business priority.
2026.10.16by 배종인 기자
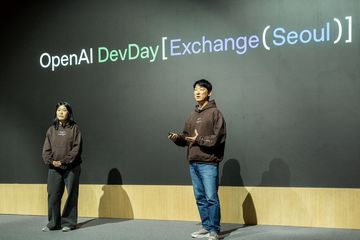
OpenAI Holds Developer Event 'DevDay Exchange' in Seoul
OpenAI held the 'DevDay Exchange' event in Seoul on the 22nd, with over 600 domestic developers in attendance. Korea currently ranks 3rd globally in weekly active users of dots and 5th in ChatGPT Pro usage, with discussions focused on agent-based work automation and enterprise AI transformation strategies. AWS and LG CNS shared phased implementation cases ranging from AI model adoption to integration with existing systems and establishment of security and governance frameworks.
2026.10.23by 배종인 기자