
KETI Releases 4 Korean Language AI Development and Evaluation Datasets
 Published2026.11.03 09:44
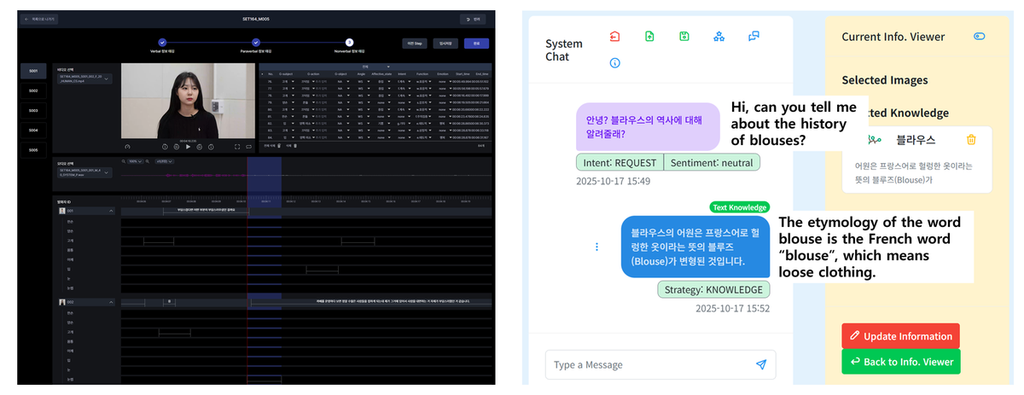
데이터셋은 정보통신기획평가원(IITP) 지원으로 구축됐으며, AI허브(AI Hub)와 허깅페이스(Hugging Face)를 통해 누구나 열람할 수 있다.
억양·발화 속도 등 준언어적 정보와 표정·시선 등 비언어적 정보를 포함해 공감형 대화 AI 개발에 활용 가능하다고 KETI 측은 설명했다.
AI가 고객의 감정·의도를 파악하는지, 요구 조건을 지속적으로 기억하는지 등 9가지 멀티모달 연계 대화 능력을 평가할 수 있다.
텍스트와 이미지를 함께 처리하는 AI가 사실과 다른 답을 생성하는 멀티모달 환각 현상을 진단하고 응답 신뢰성을 검증하는 데 쓰인다.
유해 요청 판별 능력과 안전한 답변 선택 능력을 평가하는 데 활용된다.
Comments
Related news
KETI Selected as '2026 Intellectual Property Management Excellence Institution'
Korea Electronics Technology Institute (KETI) has been selected as a government-sponsored excellence institution in recognition of its intellectual property management capabilities, including patent creation and utilization. The institute participated in the retained patent diagnosis sector for three consecutive years, diagnosing approximately 1,200 registered patents, and achieved results by registering patents with international standard patent pools Via LA and AVANCI. Over the past decade, KETI achieved 100% increase in registered patents and over 50% increase in overseas applications, and receives support from the Intellectual Property Office for patent application and registration costs for up to three years.
2026.09.15by 배종인 기자
Crest passes thermal runaway and fire safety tests for battery systems
Battery system specialist Crest has passed thermal runaway and fire safety tests at the level of North American safety standard UL 2271 Edition 3 with support from KETI and in collaboration with KCL. By applying its proprietary thermal runaway blocking and heat transfer suppression packaging technology, flame propagation was prevented even under severe test conditions, resulting in a final passing judgment. The company has established a foundation for domestic AGV and AMR companies to enter the North American market, with the goal of completing official UL 2271 Edition 3 certification in the second half of the year.
2026.09.17by 명세환 기자
KETI Develops Aqueous Dispersion Technology for Graphene Stable Storage Over One Year
The Korea Electronics Technology Institute (KETI) has developed an aqueous dispersion technology that maintains graphene at high concentration in water stably for over one year using carboxymethyl cellulose (CMC). This technology resolves existing aggregation and precipitation issues, and when applied to lithium-ion battery anode material coating, it maintains approximately 69% capacity retention even after 100 charge-discharge cycles. With compatibility across various manufacturing processes, it is expected to accelerate the timing of graphene utilization in next-generation advanced industries such as batteries.
2026.09.17by 배종인 기자
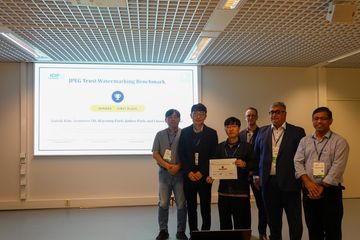
KETI wins first place in IEEE JPEG Trust Challenge…invisible watermarking technology reaches world-class level
The Korea Electronics Technology Institute (KETI) Composite Intelligence Research Center has won first place at the JPEG Trust Watermarking Challenge under the IEEE ICIP 2026 academic conference, surpassing U.S. startup Trufo. In the international competition attended by 12 countries, the team demonstrated stable watermark detection under various conditions including compression, transformation, and generative AI attacks using self-supervised learning-based invisible watermarking technology. This case confirms the international competitiveness of domestic technology amid growing demand for digital content authenticity verification driven by the expansion of generative AI.
2026.09.21by 배종인 기자
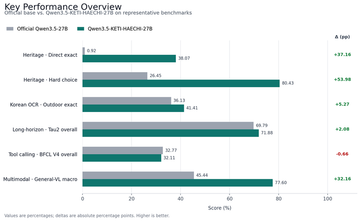
KETI Unveils 'HAECHI,' Korean Culture Heritage and Hangul-Specialized AI Model
The Korea Electronics Technology Institute (KETI) has unveiled two versions of 'HAECHI,' an AI model specialized in recognizing Hangul and Korean cultural heritage. The culture heritage identification accuracy of the HyperCLOVA X-based model improved from 5.05% to 74.16%, achieving up to a 74 percentage point enhancement, and the model can simultaneously process images and text while performing multi-stage tasks. The models are publicly available on Hugging Face for anyone to use.
2026.10.01by 배종인 기자