

노타, 키미 K3.1 Pro 최적화로 GPU 구매비용 최대 20% 절감
 기사입력2026.11.10 08:11
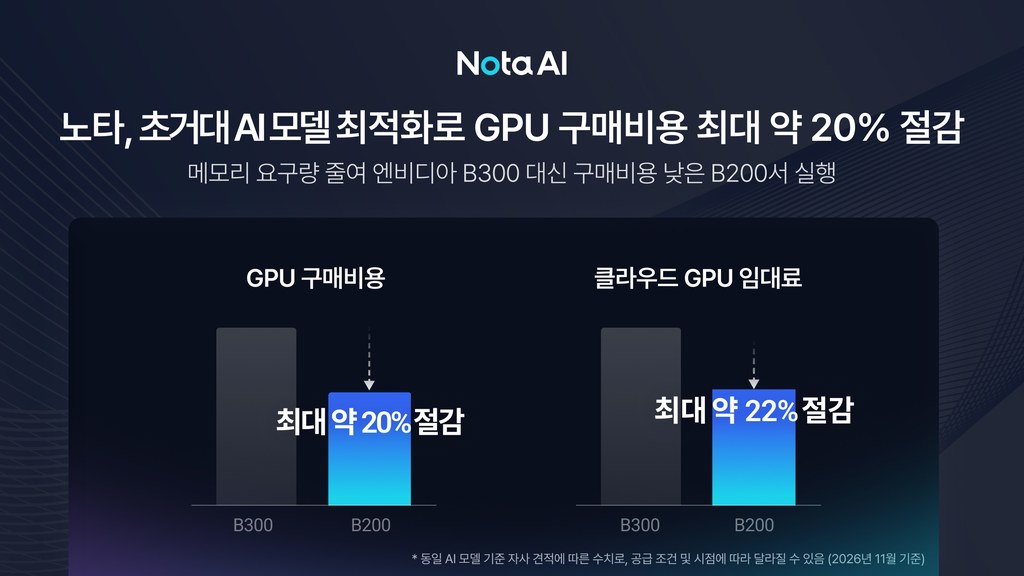
자사 견적 기준 GPU 초기 구매비용은 최대 약 20%, 클라우드 GPU 임대료는 최대 약 22% 절감 가능한 것으로 확인됐다고 노타는 설명했다.
키미 K3.1 Pro는 매개변수 2조8,000억 개를 갖춘 모델로, 현재 공개된 오픈웨이트 AI 모델 가운데 최대 규모다.
고난도 과학 추론 평가 지표인 ‘GPQA Diamond’에서는 원본 모델 점수의 99% 이상을 유지한 것으로 나타났다.
전문가 모듈을 30% 줄인 모델은 최대 51만2,000토큰, 37% 줄인 모델은 최대 100만 토큰의 문맥을 처리할 수 있다고 노타는 밝혔다.
드래프트 모델이 다음 내용을 미리 제안하고 본 모델이 이를 한 번에 검증하는 ‘추측 디코딩(Speculative Decoding)’ 방식으로, B200 환경에서도 답변 생성 속도를 높일 수 있다고 설명했다.
이번 최적화는 앞서 키미 K3의 필요 GPU를 B300 8장에서 최대 4장으로 줄인 사례에 이은 후속 성과다.
채명수 노타 대표는 “AI 경쟁력은 더 많은 고성능 GPU 확보뿐 아니라 보유한 컴퓨팅 자원에서 얼마나 높은 효율을 구현하느냐에 달려 있다”며 “기업들이 기존 인프라를 효율적으로 활용하고 새로운 모델을 합리적인 비용으로 도입할 수 있도록 최적화 소프트웨어 사업을 강화하겠다”고 말했다.
노타가 공개한 키미 K3.1 Pro 경량화 모델은 글로벌 AI 플랫폼 허깅페이스에서 확인할 수 있다.
댓글
관련 뉴스
노타, 퀄컴 NPU 기반 로봇 AI 최적화 성공…로봇팔 작업 속도 3배 향상
AI 모델 경량화 기업 노타가 퀄컴 드래곤윙 IQ-9075 NPU에서 비전언어행동모델(VLA)을 직접 구동하는 데 성공했다. 외부 GPU 없이 엣지 AI 보드만으로 로봇팔의 작업 속도를 3배 향상시키고 VLA 추론 속도는 최대 7배 개선했으며, 92% 작업 성공률을 기록했다. LG전자·모빌린트와 정부 K-온디바이스 AI 국책과제에도 참여 중이다.
2026.09.22by 배종인 기자
노타, 멀티모달 AI GPU 메모리 47% 절감
AI 모델 경량화 기업 노타가 멀티모달 AI의 전문가 혼합(MoE) 구조에 특화한 프루닝 기술을 개발했다. 약 310억 파라미터 모델에서 전문가 모듈 25%를 제거해도 원본 성능 98%를 유지하면서 GPU 메모리 사용량을 58GB에서 31GB로 47% 절감했다. 추가 학습 없이 압축이 가능해 기업 AI 인프라 운영 효율을 크게 높일 수 있다. 관련 논문이 NeurIPS 2026 메인트랙에 채택됐다.
2026.10.01by 배종인 기자
노타, AI 영상관제 솔루션으로 서버 구축 비용 최대 85% 절감
AI 모델 경량화 기술 기업 노타가 VLM 기반 영상관제 솔루션으로 서버 구축 비용을 최대 85% 절감하는 기술을 선보인다. 자체 최적화 기술을 적용하면 동일 서버 자원으로 영상 채널 수를 2배 확대할 수 있으며, 코오롱인더스트리 등 20여 개 기업이 산업안전 현장에 이미 적용 중이다. 14일부터 한국건설·안전박람회에서 중장비 안전관리, 위험 상황 검지, 보호구 착용 확인 등 기능을 공개할 예정이다.
2026.10.13by 배종인 기자
노타, Arm Create 2026서 넷츠프레소 기반 AI 최적화 도구 공개
AI 모델 경량화 기술 기업 노타가 Arm Create 2026에서 넷츠프레소 기반 ‘Arm AI Model Optimizer’의 실습 워크숍을 지원했다. 이 도구는 개발자들이 AI 모델을 목표 하드웨어에 맞춰 양자화와 그래프 최적화를 통해 효율적으로 배포할 수 있도록 지원한다. 현재 얼리 액세스 형태로 공개되며, 글로벌 개발자들의 피드백을 바탕으로 기능을 지속 개선할 예정이다.
2026.10.20by 배종인 기자
노타, AMD GPU·NPU 이기종 추론 최적화로 답변 완료 시간 52% 단축
AI 모델 경량화 기업 노타가 AMD 라이젠 AI Max+ 395 환경에서 GPU와 NPU를 결합한 이기종 추론 최적화 기술을 선보였다. 프리필 단계는 NPU, 디코드 단계는 GPU가 담당하도록 역할을 분리하고 메모리 공유를 최적화한 결과, 답변 완료 시간을 최대 52% 단축하고 토큰당 에너지 소비를 31% 절감했다. 이 기술은 AI PC와 로보틱스 등 엣지 디바이스 분야로 적용 가능하다.
2026.11.09by 배종인 기자