

구글 클라우드, TPU 8tx·TPU 8i 맥스 공개…8세대 TPU 포트폴리오 완성
 기사입력2026.11.10 09:14
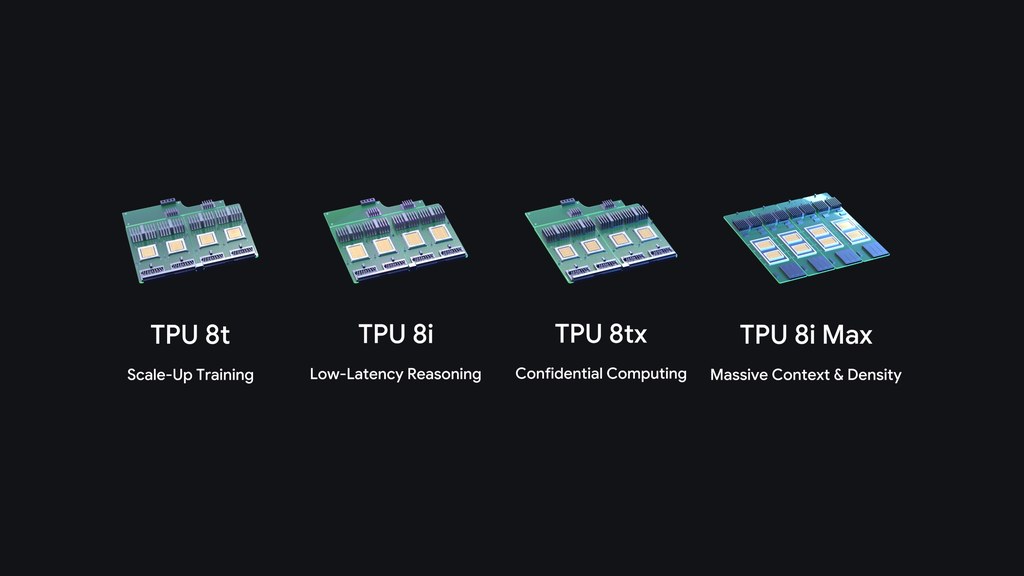
아민 바닷(Amin Vahdat) 구글 AI 및 인프라 부문 수석부사장 겸 최고기술자는 “컴퓨팅의 기준이 사람에서 에이전트로 넘어가고 있다”며 “기업들은 AI 모델의 방대한 컨텍스트 윈도우(context window) 전체를 추론할 수 있는 가속기를 찾고 있다”고 설명했다.
일반적으로 데이터는 연산 처리 중 메모리에서 복호화되는데, TPU 8tx는 이 구간에서도 민감한 데이터와 모델 가중치를 보호·격리한다고 회사 측은 전했다.
실시간 추론을 위해 개발된 저지연 보드플라이(Boardfly) 네트워크를 적용해 TPU 8t 대비 지연 시간을 최대 절반까지 줄일 수 있으며, 성능 저하는 거의 없다고 밝혔다.
기업은 별도 클러스터 없이 자체 데이터로 미세 조정(fine-tune), 모델 증류, 강화학습 기반 에이전트 학습을 하나의 시스템에서 수행할 수 있다.
기존 서버 랙 공간에 2배의 칩을 탑재할 수 있어 데이터센터의 단위 면적당·와트당 컴퓨팅 밀도를 높일 수 있다고 덧붙였다.
구글은 현재 프런티어 AI 연구소, 금융·리테일 기업, 대학 등 100여 곳에 TPU를 직접 구축하는 형태로 서비스를 확대하고 있다.
댓글
관련 뉴스

넷앱·구글 클라우드, 통합 스토리지 서비스 정식 출시
넷앱과 구글 클라우드가 파일과 블록 워크로드를 하나의 스토리지 환경에서 운영할 수 있는 통합 서비스를 정식 출시했다. 양사는 Google Cloud NetApp Volumes 기반의 Flex Unified 서비스와 NetApp Data Migrator를 통해 기업의 클라우드 이전과 AI 워크로드 운영 부담을 줄인다는 계획이다. 이번 발표는 기업들이 기존 애플리케이션 구조를 크게 바꾸지 않고도 데이터베이스, HPC, EDA, VMware 등 고성능 워크로드를 클라우드 환경에서 운영할 수 있도록 지원한다는 점에서 의미가 있다.
2026.06.04by 배종인 기자

구글 클라우드·삼성전자, 에이전틱 AI 협력 확대…DX부문 전원 도입
구글 클라우드와 삼성전자가 에이전틱 AI 분야 협력을 확대한다. 삼성전자 DX부문 임직원 전원에 제미나이 엔터프라이즈를 배포하며, 이는 국내 최대 규모의 엔터프라이즈 에이전틱 AI 도입 사례다. 전용 구글 클라우드 테넌트 환경에서 데이터 주권을 확보하면서 사내 분산 시스템을 단일 접점으로 연결하고, 향후 멀티스텝 AI 에이전트와 로우코드·노코드 기반 업무 특화 에이전트 개발을 지원할 계획이다.
2026.07.13by 명세환 기자

구글 클라우드, 오라클 엔터프라이즈 앱에 제미나이 모델 도입
구글 클라우드와 오라클이 협력을 확대해 오라클 퓨전 클라우드와 넷스위트 등 주요 엔터프라이즈 애플리케이션에 제미나이 3.1 Flash Lite와 3.5 Flash 모델을 탑재한다. AI 에이전트 스튜디오와 연동하여 기업 고객이 실무 환경에서 직접 AI를 활용하고 업무 자동화 및 의사결정을 가속화할 수 있도록 접근성을 확대하는 전략이다.
2026.08.03by 배종인 기자

구글 클라우드·신한투자증권, AI 에이전트 플랫폼 구축 완료
신한투자증권이 구글 클라우드와 협력해 금융 규제를 준수하면서 사내 핵심 업무 시스템과 연동되는 AI 에이전트 플랫폼을 완성했다. 하이브리드 오케스트레이터 자체 설계로 안정성과 유연성을 확보했으며, 장외파생상품 계약서 처리 시간을 2시간에서 5분으로 단축했다.
2026.08.18by 명세환 기자
구글 클라우드, 금융·법률 특화 제미나이 엔터프라이즈 출시
구글 클라우드가 금융·법률 분야에 특화된 제미나이 엔터프라이즈 솔루션을 출시했다. 금융용은 13개 데이터소스 커넥터와 금융 리서치 에이전트를 통해 신뢰도 검증과 감사 추적을 지원하며, 법률용은 9개 플랫폼 연동과 정보차단벽·데이터격리로 컴플라이언스를 보장한다. 엔터프라이즈급 보안·거버넌스와 함께 산업 특화 AI 시장 진입을 본격화했다.
2026.08.26by 명세환 기자