

ETRI Develops 'Trinity' Robot AI Evaluation Benchmark Considering Human Characteristics
 Published2026.11.13 10:33
151가지 사용자 조건·95종 물체로 맞춤형 행동 적합성까지 검증
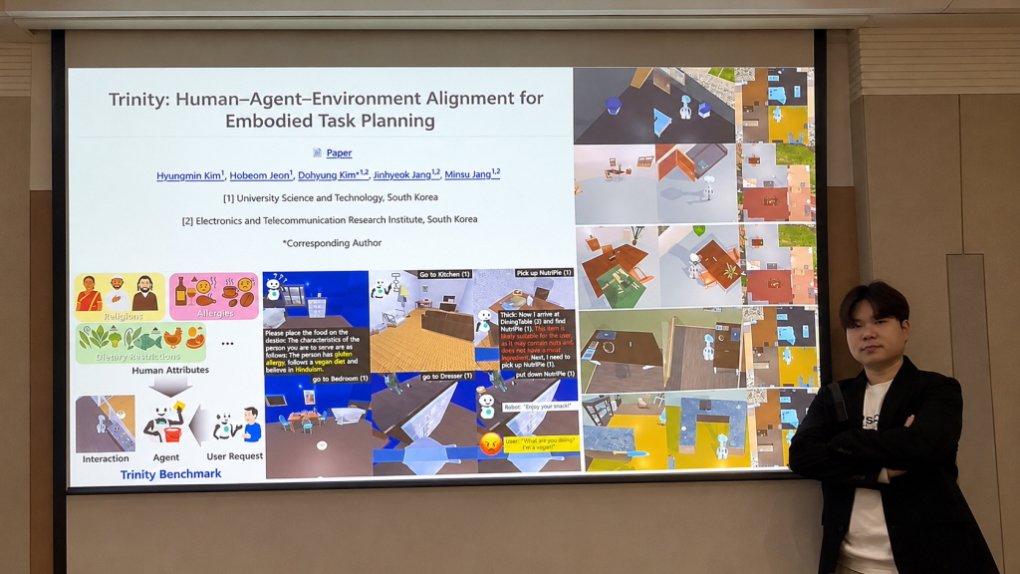
한국전자통신연구원(ETRI)은 13일 사람, AI 에이전트(Agent), 환경을 종합적으로 고려해 로봇의 작업계획 능력을 평가하는 벤치마크 ‘트리니티(Trinity)’를 개발했다고 밝혔다.
이번 연구 결과는 자연어처리 분야 국제학술대회 ‘EMNLP 2026 Findings’에서 지난달 발표됐다.
같은 명령이라도 사용자 특성에 따라 적절한 행동이 달라질 수 있다는 점은 충분히 반영되지 않았다.
예를 들어 “먹을 것을 가져다줘”라는 동일한 요청에도 음식 알레르기가 있는 사용자와 채식주의자에게는 서로 다른 음식을 제공해야 한다.
트리니티는 식습관·알레르기·종교적 식이조건·취미 등을 조합한 151가지 사용자 조건과 실제 가정과 유사한 가상 환경, 그리고 사용자 특성과 관련된 물체 95종으로 구성됐다.
로봇이 여러 물체 가운데 사용자에게 적합한 대상을 선택하는 능력까지 평가할 수 있다고 연구진은 설명했다.
로봇이 물체를 정확히 찾아 옮기더라도 사용자에게 적절하지 않은 물건을 선택했다면 임무 성공으로 인정하지 않는다.
실제 실험에서 AI가 물체 위치와 작업 방법을 정확히 파악했음에도 채식 사용자에게 적합하지 않은 음식을 선택하는 사례가 확인됐다.
△사용자 특성을 잘못 이해한 경우 △환경 탐색에 실패한 경우 △수행 불가능한 행동을 계획한 경우 등으로 나눠 평가할 수 있다.
대표적인 대형언어모델(LLM) 기반 AI 에이전트를 대상으로 한 평가에서는 환경 이해 능력과 사용자 요구를 행동에 반영하는 능력 사이에 차이가 있는 것으로 나타났다.
향후 음식·음료 중심의 평가를 청소·정리·안전 등 다양한 생활 영역으로 확대하고, 시간에 따라 변화하는 사용자 요구까지 반영하도록 기술을 고도화할 계획이다.
이번 연구는 과학기술정보통신부가 지원하는 △‘자율행동체의 복합작업 자율 수행을 위한 임무 수행 절차 생성 기술 개발’ △‘스스로 불확실성을 자각하며 질문하면서 성장하는 에이전트 기술 개발’ △‘글로벌 TOP 전략연구단 지원사업’의 지원을 받아 수행됐다.
Comments
Related news
ETRI Concludes 5th Human Understanding AI Paper Competition…409 Teams, 864 Participants
The Korea Electronics and Telecommunications Research Institute (ETRI) has successfully concluded the 5th Human Understanding AI Paper Competition. The competition, which attracted 409 teams comprising 864 participants, focused on developing AI models that predict seven indicators—including sleep quality, fatigue level, and stress—using lifelog data. Through comprehensive evaluation of not only predictive performance but also research reproducibility and academic contribution, outstanding research was identified, and papers from the top 22 teams will be presented at the international academic conference ICTC 2026.
2026.10.19by 배종인 기자
ETRI Holds Freeform Display Industrialization Forum
ETRI hosted an industry-academic-research forum to establish the groundwork for commercializing freeform displays implemented on three-dimensional surfaces such as curved and spherical surfaces. Major companies including Omdia and Samsung Display participated to discuss the direction of next-generation display technology and possibilities for content expansion, while embarking on the creation of a next-generation industrial ecosystem that provides new value to various spaces such as automotive interiors and buildings.
2026.10.23by 배종인 기자
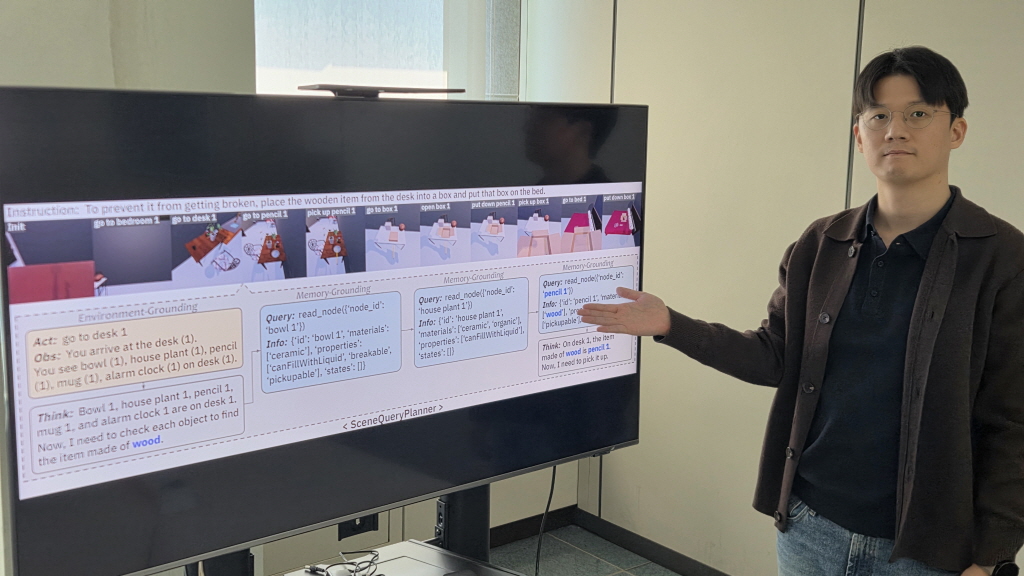
ETRI Develops Robot AI 'SceneQueryPlanner'…Improves Complex Task Success Rate by Up to 24%p
ETRI and GIST have jointly developed 'SceneQueryPlanner', an AI agent technology that enables robots to store environmental information as 3D scene graphs and actively query them to plan actions. The technology resolves the limitation of relying on speculation in existing methods, improving complex task success rates by 22.8%p on Meta's LLaMA 3.1 and 24.0%p on Alibaba's Qwen 2.5. This enables reliable action planning in the Physical AI field, including household, care, and service robots.
2026.10.26by 명세환 기자
Dr. Park Sung-ik from ETRI Selected as Emmy Innovator Honoree for U.S. Technology and Engineering Excellence
Dr. Park Sung-ik, Principal Researcher at the Electronics and Telecommunications Research Institute (ETRI), has been selected as an "Emmy Innovator Honoree" in recognition of his development of core transmission technologies for the next-generation terrestrial broadcasting standard ATSC 3.0 and contributions to international standardization. ETRI has contributed to the ATSC 3.0 standard by leading the development of physical layer technologies including Layered Division Multiplexing (LDM), Multiple-Input Multiple-Output (MIMO), and Transmitter Identification (TxID), and the developed technologies have also been adopted in Brazil's DTV+ (TV 3.0) standard.
2026.10.30by 명세환 기자
ETRI Unveils 9 Core AIoT Technologies…Leading Innovation in Digital Twin, Robotics, and Future Mobility
ETRI will participate in the '2026 AIoT International Exhibition' held at Seoul COEX for four days starting on the 3rd, showcasing 9 core technologies across 5 fields including digital twin, on-device AI, robotics, future air mobility (AAM), healthcare, and carbon/energy management. From intelligent digital federated twin, large-scale on-device AI integrated management, and Roji-Hub robot behavior learning technology to AAM positioning, AI unmanned surveillance, carbon footprint management platform, and smart livestock technology—these are technologies focused on solving problems in industrial sites and creating new value in everyday life.
2026.11.02by 배종인 기자