

인텔 GPU D270, AI 추론·HPC 융합 워크로드 지원
 기사입력2026.11.17 11:50
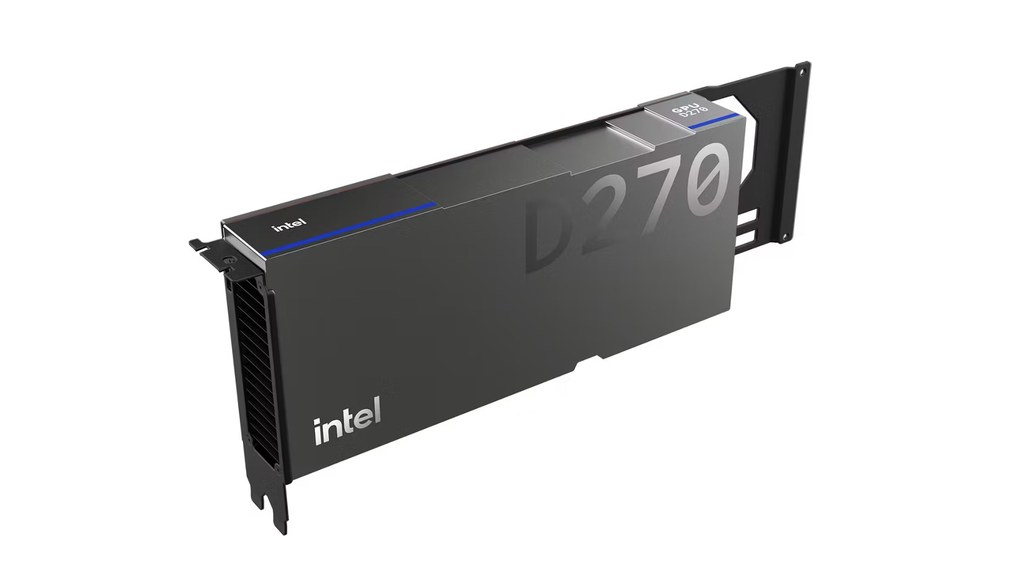
D270은 인텔 Xe 3P 아키텍처 기반으로 32개 Xe 코어와 256개 XMX(Xe 매트릭스 익스텐션) 엔진을 탑재했으며, FP4부터 FP64까지 네이티브 연산을 지원한다.
160GB LPDDR5X 메모리와 초당 1.5TB 대역폭을 제공하고, 파트너사 구성에서는 메모리 용량을 최대 480GB까지 확장할 수 있다.
전력 설계는 350W이며 PCIe 5.0 공랭식 폼팩터를 채택해 일반 엔터프라이즈 서버에 탑재 가능하다.
D270은 각 Xe 코어에서 64회의 FP64 융합 곱셈-덧셈(FMA) 연산을 지원해 추론 처리량 최적화용 저정밀도 연산과 고정밀 수치 계산을 모두 처리할 수 있다.
인텔이 2026년 11월 6일 자체 테스트한 금융 서비스 옵션 가격 산정 벤치마크에서 D270은 엔비디아 RTX PRO 6000 블랙웰 서버 에디션(NVIDIA RTX PRO 6000 Blackwell Server Edition) 대비 최대 5.9배 높은 처리량을 기록했다.
세부 항목별로는 △유럽형 몬테카를로 5.9배 △블랙-숄즈(유럽형) 5.6배 △이항 모형 4.6배 △블랙-숄즈(미국형) 1.92배 향상이다.
엔비디아 GPU가 600W를 소비하는 반면 D270은 350W로 작동한다.
지진파 모델링 분야에서는 대용량 메모리를 활용해 대규모 파동장 배열을 GPU 메모리에 직접 상주시키고 데이터 이동 비용을 줄이는 방식으로 처리 효율을 높인다는 설명이다.
인텔은 시카고에서 개최되는 슈퍼컴퓨팅 2026(Supercomputing ‘26) 전시 부스에서 지진파 모델링 역량을 실시간 데모로 선보일 예정이다.
D270은 연산 집약적인 프리필(prefill) 단계를 담당하고, 메모리 의존도가 높은 디코드(decode) 단계는 삼바노바 SN50 재구성 가능 데이터플로 유닛(Reconfigurable Dataflow Units, RDU)이 처리하는 방식이다.
인텔과 삼바노바는 SC26 전시 부스에서 이 분리형 이기종 추론 아키텍처를 실시간으로 시연할 예정이다.
에이전틱 AI 추론 성능 측면에서 D270은 Drex 2.0 실행 시 경쟁 GPU 대비 최대 29% 낮은 지연 시간을 기록했으며, Qwen 3 30B-A3B 모델에서는 1.12배 높은 처리량을 350W 전력으로 제공했다.
소프트웨어 환경과 관련해 인텔은 개방형 SYCL 프로그래밍 모델을 중심으로 기존 HPC 코드베이스를 대규모 재작성 없이 D270에 이식할 수 있다고 밝혔다.
베리디언(Veridien)의 지진파 영상화 미니 애플리케이션은 한 달 이내에 이식이 완료됐으며, 전체 커널의 90%는 인텔 전용 최적화 없이도 우수한 성능을 보였다고 전했다.
댓글
관련 뉴스
인텔, 韓 ‘피지컬 AI’ 전초기지 낙점…“AI 다음 전장은 산업 현장”
인텔은 2026 인텔 AI 서밋 서울에서 AI 산업의 다음 전장을 초거대 모델 경쟁이 아닌 소버린 AI, 에이전틱 AI, 피지컬 AI로 규정했다. 특히 한국을 반도체와 로보틱스, AI 인프라 역량을 갖춘 핵심 거점으로 평가하며 'K-AI 풀스택 얼라이언스'를 출범시켰다. 인텔은 단순한 칩 공급업체를 넘어 CPU·GPU·NPU·ASIC을 아우르는 개방형 플랫폼과 생태계를 제공해 한국형 AI 주권 구축과 산업 현장의 피지컬 AI 확산을 이끄는 전략적 파트너 역할을 맡겠다는 비전을 제시했다.
2026.11.12by 배종인 기자
파네시아-인텔, CXL 기술 협력 맞손
국내 팹리스 기업 파네시아가 인텔코리아와 CXL 기술 협력 MOU를 체결했다. 양사는 인텔 제온 플랫폼과 파네시아의 PCIe 6.4-CXL 3.2 퓨전 스위치 연동 검증을 시작으로, 랙 단위 메모리 확장 기반의 AI 인프라 구축까지 단계적으로 협력을 확대한다. 이를 통해 대규모 AI 모델 학습에 필요한 메모리 한계를 극복하고 데이터센터 도입을 가속화할 계획이다.
2026.11.12by 배종인 기자
인텔, 서울 AI 허브와 스타트업 기술 지원 맞손
인텔코리아가 서울 AI 허브와 업무협약을 체결하고 국내 AI 스타트업 육성에 나섰다. 85시간 규모의 디지털 레디니스 커리큘럼, 개발 자원 제공, 전문가 멘토링 등을 통해 에이전틱 AI·피지컬 AI 솔루션 개발을 지원한다. 글로벌 스타트업 프로그램의 국내 첫 도입으로, 2027년 서울시 글로벌 빅테크 센터 조성과 연계한 해외 진출을 함께 추진할 계획이다.
2026.11.13by 배종인 기자
인텔, 금융·공공 분야 엣지 AI 기술 협력 확대
인텔코리아가 메사쿠어컴퍼니, NH농협은행과 협력해 인텔 아크 Pro B70 GPU를 적용한 AI 영상통화 기반 비대면 본인확인 전용 어플라이언스 사례를 공개했다.
2026.11.13by 배종인 기자
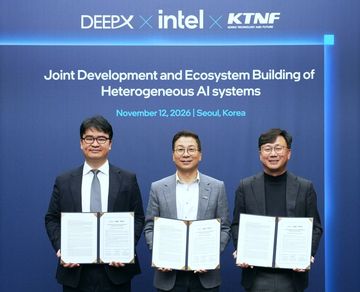
딥엑스, 인텔코리아와 OpenVINO·NPU 연동 추진
AI 반도체 기업 딥엑스가 인텔코리아, 서버 전문기업 KTNF와 손잡고 AI 추론 기술 협력에 나선다. 딥엑스의 NPU와 인텔의 OpenVINO 소프트웨어 연동을 중심으로 이기종 컴퓨팅 기반 온프레미스 AI 서버를 개발한다. 나아가 로봇·Physical AI 분야 적용과 차세대 생성형 AI NPU인 DX-M2 기반 기업용 솔루션 개발도 추진할 예정이다.
2026.11.13by 배종인 기자