

Nota Optimizes AI Agent Full Stack…Work Time Reduced by Up to 47%
 Published2026.11.18 08:53
별도의 장비 증설이나 모델 교체 없이 동일한 컴퓨팅 환경에서 AI 서비스 운영 효율을 높일 수 있다고 밝혔다.
에이전트가 모델을 호출하고 도구를 사용하며 결과를 검증하는 과정에서 응답 길이·파일 수정 이력·도구 실행 결과 등을 실시간으로 분석해 상황에 맞는 추론 강도를 선택하는 방식이다.
이미 통과한 검증이나 불필요한 재검토를 줄여 필요한 단계에 연산 자원을 집중하도록 했다.
GPU 커널은 하드웨어 특성에 맞춰 조정하고, 여러 GPU가 빠른 실행 설정을 공유하도록 해 중복 튜닝 부담을 줄였다고 노타는 설명했다.
△Terminal-Bench 2.1 △SWE-bench Multilingual 두 평가 지표를 활용했다.
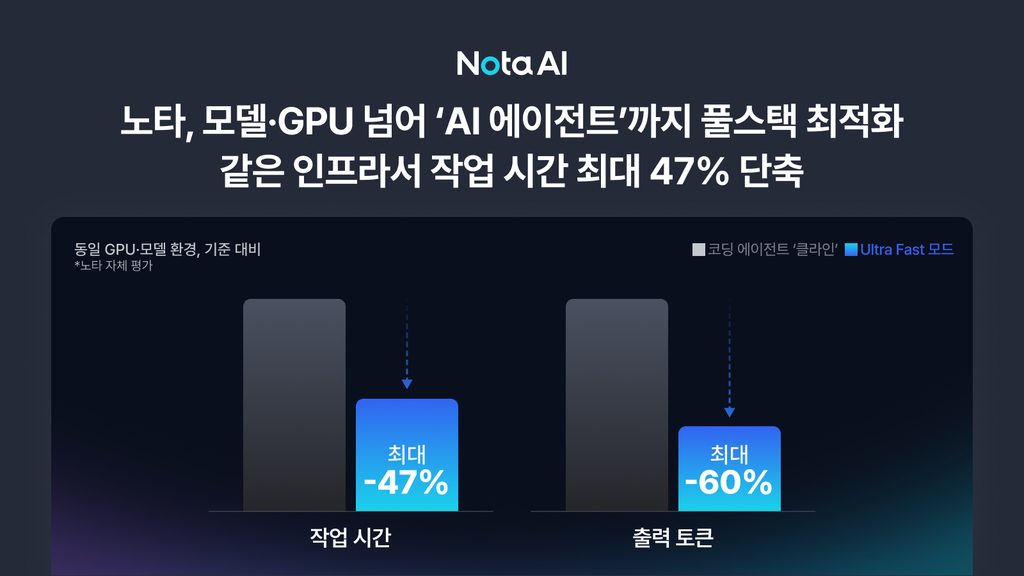
반복 검증까지 억제하는 Ultra Fast 모드는 작업 시간 최대 47%, 출력 토큰 최대 60%를 절감했다.
다만 소프트웨어 오류 수정 평가에서는 문제 해결률이 기준치 65.7%에서 62.0%로 낮아져 작업 유형과 최적화 수준에 따라 처리 효율과 해결률에 차이가 나타났다.
노타는 이번 기술을 기업용 AI 에이전트와 생성형 AI 서비스로 확대 적용하고, 최적화 소프트웨어 라이선스 사업으로 연결한다는 계획이다.
Comments
Related news
Nota, Multimodal AI GPU Memory Reduced by 47%
AI model optimization company Nota has developed a pruning technique specialized in the Mixture of Experts (MoE) structure for multimodal AI. The company achieved a 47% reduction in GPU memory usage from 58GB to 31GB while maintaining 98% of the original performance, even after removing 25% of expert modules from an approximately 31-billion parameter model. Compression is possible without additional training, which can significantly improve the efficiency of enterprise AI infrastructure operations. The related paper has been accepted to the main track of NeurIPS 2026.
2026.10.01by 배종인 기자
Nota Reduces Server Construction Costs by Up to 85% with AI Video Surveillance Solution
Nota, an AI model optimization technology company, is introducing technology that reduces server construction costs by up to 85% through its VLM-based video surveillance solution. By applying its own optimization technology, the number of video channels can be doubled with identical server resources, and over 20 companies including Koolon Industries have already applied it in industrial safety sites. Starting from the 14th, the company plans to unveil features including heavy equipment safety management, hazard situation detection, and protective gear compliance verification at the Korea Construction and Safety Expo.
2026.10.13by 배종인 기자
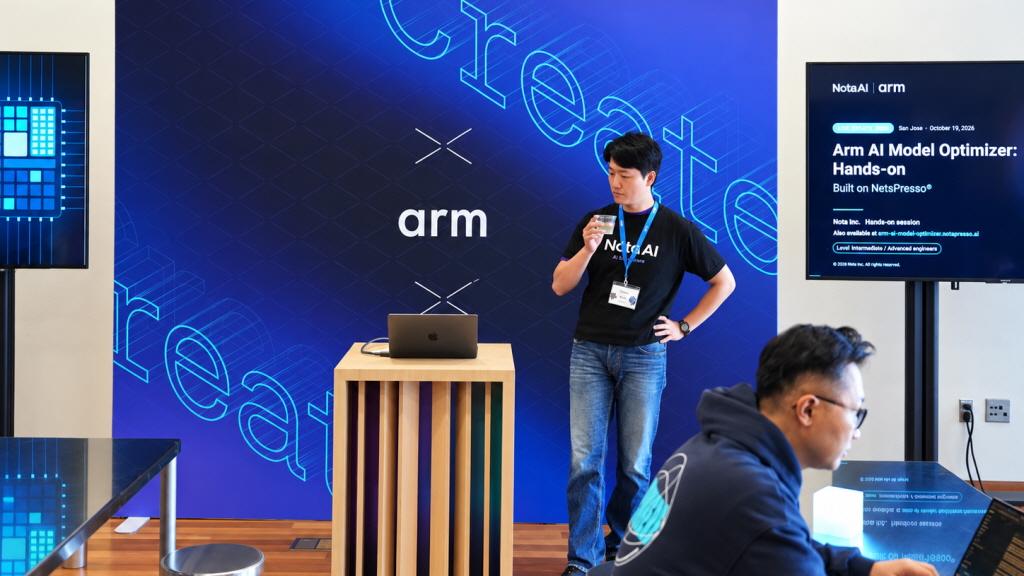
Nota Unveils Netspresso-Based AI Optimization Tool at Arm Create 2026
AI model optimization technology company Nota supported hands-on workshops for the 'Arm AI Model Optimizer' based on Netspresso at Arm Create 2026. This tool enables developers to efficiently deploy AI models to target hardware through quantization and graph optimization. Currently available in early access form, the company plans to continuously improve features based on feedback from global developers.
2026.10.20by 배종인 기자
Nota Achieves 52% Reduction in Response Completion Time through AMD GPU·NPU Heterogeneous Inference Optimization
AI model optimization company Nota has demonstrated heterogeneous inference optimization technology combining GPU and NPU in the AMD Ryzen AI Max+ 395 environment. By dividing roles such that the NPU handles the prefill stage and the GPU handles the decode stage, and by optimizing memory sharing, the company achieved a maximum 52% reduction in response completion time and a 31% decrease in energy consumption per token. This technology is applicable to edge device sectors including AI PCs and robotics.
2026.11.09by 배종인 기자
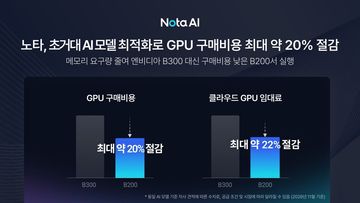
Notta Optimizes Moonshot AI's Kimi K3.1 Pro, Reducing GPU Purchase Costs by Up to 20%
AI inference optimization company Notta has optimized Moonshot AI's large-scale model "Kimi K3.1 Pro" using pruning technology, making it possible to run on 8 NVIDIA B200 GPUs instead of B300 GPUs. GPU purchase costs can be reduced by up to 20%, and cloud rental fees by up to 22%, while maintaining over 99% of GPQA Diamond performance. Inference speed has also been improved through speculative decoding technology.
2026.11.10by 배종인 기자