
[인터뷰] 마테오 마라비타 ST AICC 센터장, “저전력·고효율 임베디드 AI 플랫폼으로 엣지 AI 대중화 이끌 것”
 기사입력2026.10.08 11:11
“저전력·고효율 임베디드 AI 플랫폼으로 엣지 AI 대중화 이끌 것”
엣지 AI, 빠른 응답 속도·전력 및 비용 절감·보안성 향상
STM32N6, 고성능 비전·오디오 AI를 MCU 환경서 구현
[편집자주]최근 AI의 중심이 빠른 응답 속도, 전력 및 비용 절감, 보안성 향상 등을 이유로 클라우드에서 엣지로 이동하고 있다. 또한 임베디드 AI 개발에서는 제한된 메모리 환경에 맞춘 모델 최적화가 중요시 되고 있다. 이런 가운데 ST마이크로일렉트로닉스(STMicroelectronics)는 STM32N6의 Neural-ART 가속기를 통해 고성능 비전·오디오 AI를 MCU 환경에서 구현해 비용과 전력 소모를 줄이는데 적극 나서고 있다. 또한 기술 지원과 개발 생태계를 통해 고객의 AI 아이디어가 양산까지 이어지도록 지원하고 있다. 이런 가운데 본지는 마테오 마라비타(Matteo Maravita) ST APAC AI Competence Center(AICC) 센터장과 만나 엣지 AI의 발전 방향과 ST의 전략에 대해 들어 봤다.
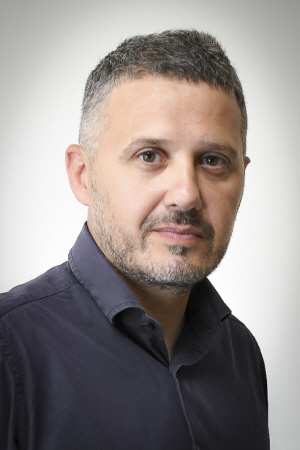
아태지역 AI 역량센터(AI Competence Center, AICC)를 이끌고 있는 마테오 마라비타(Matteo Maravita)이며, 현재 ST 홍콩 오피스에서 근무하고 있다.
제가 이끄는 팀은 ST 제품 및 생태계를 기반으로 한 AI 관련 프로젝트와 관련하여 아시아 지역 내 기술 지원과 수요 창출을 담당하고 있으며, 일본, 대만, 중국에 팀원들이 있다.
AICC의 핵심 역할은 임베디드 AI를 다루는 고객을 지원하는 것이다.
특히 임베디드 AI를 처음 접하는 고객을 지원하는 데 중점을 두고 있다.
고객의 아이디어를 먼저 PoC(개념 증명) 프로젝트로 구체화하고, 이후 양산 단계까지 이어질 수 있도록 지원하는 것이 저희의 주요 역할이다.
■ AI의 중심이 클라우드에서 엣지로 이동하는 가장 큰 원인은
여러 가지 이유가 있다. 인터넷 연결을 항상 유지할 필요가 없다는 점, 빠른 응답 속도, 클라우드로의 데이터 전송이 줄어듦에 따른 전력 소모 감소와 비용 절감, 그리고 보안성 향상(데이터가 로컬에 남는다는 점) 등이다.
■ 제한된 전력과 메모리를 가진 임베디드 시스템에서 AI 성능을 높이려면 어떤 기술적 균형이 필요한가
개발자가 가장 주의 깊게 살펴야 할 점은 메모리 사용량이다.
많은 AI 개발자들은 ‘무제한에 가까운 메모리’를 사용할 수 있는 Linux 머신에서 작업하는 데 익숙하다.
반면에 임베디드 시스템으로 넘어오면, 선택한 마이크로컨트롤러의 메모리 용량 안에서 AI 모델이 동작할 수 있도록 모델의 크기에 훨씬 더 주의를 기울여야 한다.
대부분의 경우, 이는 그리 큰 제약 사항은 아니다.
임베디드 AI의 사용 사례들을 살펴보면 (LLM과 같은 예외적인 경우를 제외) 일반적으로 복잡한 AI 모델을 요구하지 않기 때문입니다.
■ STM32N6의 Neural-ART 가속기는 기존 MCU 기반 AI 개발 방식을 어떻게 변화시킬 수 있는지 궁금하다
ST의 독자적인 NPU(Neural Processing Unit), Neural-ART Accelerator™가 탑재된 STM32N6는 첨단 컴퓨터 비전 및 오디오 AI 모델을 마이크로컨트롤러 환경에서 고속으로 실행할 수 있다(최신 YOLO 사물 감지 모델의 경우 일반적으로 초당 30프레임).
이는 몇 년 전만 해도 FPGA 혹은 고사양 애플리케이션 프로세서에서만 가능했던 수준으로서, 기존에는 유사한 처리를 위해 Linux 기반 프로세서와 외부 DRAM, 별도의 전원 설계가 필요했다면, STM32N6를 활용하면 MCU 기반으로 보다 낮은 비용과 전력 소비, 빠른 부팅을 구현할 수 있다.
STM32N6 및 ST 엣지 AI 솔루션을 활용한 실제 적용 사례들을 ST Edge AI Suite에서 확인할 수 있다.
■ 생성형 AI를 엣지에 구현할 때 소형 언어 모델만으로 충분한지. 클라우드의 대형 모델과 엣지 모델을 결합하는 하이브리드 구조가 필요하다면, 모델 분할과 데이터 처리 기준은 어떻게 설정해야 하는지 궁금하다
이미 여러 고객과 함께 하이브리드 방식을 적용한 프로젝트 사례들이 있다.
소형 엣지 AI 모델은 저희 마이크로컨트롤러에서 구동하고, 보다 고도화된 LLM 기능이 필요한 경우에는 클라우드에 연결하는 방식이다.
대표적인 예로는 음성 명령을 통한 LLM 모델 및 AI 에이전트와의 상호작용이 있다.
마이크로컨트롤러에서 프론트엔드 엣지 AI 모델을 사용하여 주변 소음을 제거하고, 음성 활동을 감지하고, 음성을 텍스트로 변환하며, 매우 낮은 전력 소모(항상 기능 활성화)와 빠른 응답 속도를 유지한다.
텍스트 데이터가 준비되면 클라우드상의 LLM 모델로 전송하는데, 이 과정에서 전송되는 데이터의 양을 최소화한다.
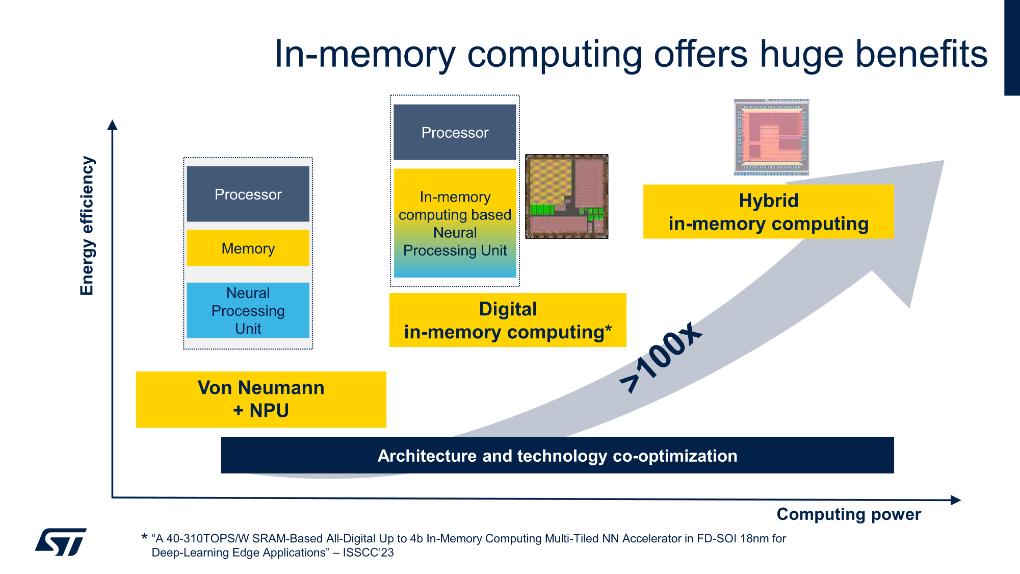
■ 생성형 AI가 에이전틱 AI와 피지컬 AI로 발전하면서 새로운 위험도 커질 것으로 보인다. 환각, 보안, 신뢰성, 실시간 안전 문제를 임베디드 기기 수준에서 어떻게 검증하고 통제해야 하며, ST는 이를 위해 어떤 역할을 준비하고 있는지
앞서 제기된 우려는 모두 현실적인 문제이며, 애플리케이션 개발자들 역시 이러한 위험을 완화하고 다루는 방법에 대한 새로운 ‘기술 문화’를 갖춰나가야 한다.
이러한 문제를 해결하는 가장 간단한 방법은 상위 애플리케이션 수준에서 AI 모델 출력에 대한 가드레일을 적용하고, 여러 단계의 검증을 거치며, AI 모델의 출력을 기존 알고리즘과 결합하는 것이다.
우리는 지난 몇 년간 여러 고객의 다양한 사용 사례를 통해 상당한 경험을 축적해 왔다.
이러한 경험을 바탕으로 임베디드 AI를 처음 도입하는 고객에게 AI 도구와 모델뿐만 아니라 애플리케이션 전반에 걸쳐 현지의 ST 엔지니어를 통해 전문 기술 지원을 제공하고 있다.
■ 마지막으로 독자들에게 하고 싶은 말이 있다면
임베디드 AI는 지난 몇 년간 혁신적인 변화를 이끌어왔다.
ST의 솔루션을 채택하는 고객이 증가하는 동시에 트랜스포머(Transformers)와 같은 새로운 AI 모델 아키텍처 역시 매우 빠르게 도입되는 것을 목격했다.
새로운 기술을 시장에 선보이고, 그것이 실제 제품에 적용되어 최종 사용자에게 제공되는 모습을 지켜보는 것은 우리에게도 매우 도전적이면서도 한편으로는 흥미로운 일이다.
ST는 칩을 공급하는 기업을 넘어, 엣지 AI 시대에 고객과 오랜 시간 함께 성장하는 신뢰받는 기술 파트너가 되고자 한다.
엣지 AI 분야에서 10년 이상 쌓아온 전문 경험을 기반으로 제품의 안정적인 공급은 물론 사용자 친화적인 개발 툴과 새로운 AI 활용 사례 패키지 개발, 전문적인 기술 지원을 통해 고객의 아이디어를 실제 양산까지 구현하는 여정에 함께하겠다.
댓글
관련 뉴스

[인터뷰]마테오 마라비타 ST AI 역량센터 센터장-“딥 엣지 AI 데이터 폭발, ST 솔루션으로 해결”
AI 한계를 극복하는 딥 엣지 기술과 머신러닝, AI프로세스에 대해 ST마이크로일렉트로닉스 AI 역량센터 센터장으로 들어보는 자리를 마련했다.
2021.11.19by 배종인 기자
[기고]마테오 마라비타 ST 센터장-“딥 엣지, AI 한계 극복·지속 성장”
2030년 25억개의 장치 출하로 급속한 성장이 예상되는 딥 엣지에 대해 마테오 마라비타 ST AI 센터장의 견해를 들어보는 자리를 마련했다.
2021.11.26by 명세환 기자

마테오 마라비타 ST AICC 센터장, “고객 AI 프로젝트 개발 긴밀 지원”
ST마이크로일렉트로닉스(STMicroelectronics)는 임베디드 AI 솔루션 개발을 지원하는 조직인 AI 역량센터(AI Competence Center)를 운영하고 있다. AICC는 임베디드 AI를 처음 접하는 고객을 중심으로 PoC 단계부터 양산·현장 배포까지 전 과정을 지원하며, 문제 정의와 데이터셋 선정 등 초기 단계의 어려움을 해소하는 데 주력한다. ST는 센서·MCU·엣지 AI 포트폴리오와 Edge AI Suite를 통해 AI 모델의 학습·개발·배포를 단순화하고, 풍부한 툴과 사례로 개발 진입 장벽을 낮추고 있다. 또한 AICC는 현지 FAE 및 내부 조직과 협업해 교육과 세미나를 제공하며, ST는 APAC AI 생태계에서 임베디드 AI 리더로 자리매김하는 것을 목표로 하고 있다. 이에 AICC의 센터장을 맡고 있는 마테오 마라비타(MATTEO MARAVITA)와 이야기를 나눠봤다.
2026.02.19by 배종인 기자
“AI의 다음 무대는 ‘물리적 세계’, 저전력·고효율이 관건”
‘e4ds Physical AI Frontier 2026’ 콘퍼런스에서 마테오 마라비타(MATTEO MARAVITA) ST마이크로일렉트로닉스(STMicroelectronics) APAC 지역 세일즈 & 마케팅 AI 역량센터 센터장은 ‘임베디드 시스템을 위한 AI 솔루션, 생성형 AI 구현 과연 지속가능한가?’라는 주제로 발표하며, 인공지능(AI) 기술의 진화 방향과 반도체 산업의 역할을 짚었다. 그는 “AI가 디지털을 넘어 물리적 세계로 확장되는 전환점에서, 저전력·고효율 반도체 기술의 중요성은 더욱 커지고 있다”며, 반도체 아키텍처 혁신을 강조했다.
2026.03.17by 배종인 기자
“기술을 아는 시대 넘어 기술을 증명하는 시대”…e4ds Tech Day 2026 성료
e4ds가 9월 8일 한국과학기술회관에서 개최한 ‘e4ds Tech Day 2026’이 성황리에 막을 내렸다. 이번 행사는 SDV와 엣지 AI를 중심으로 기술 자체보다 실제 산업 현장에서의 적용 기준과 활용 방향을 제시하는 데 초점을 맞췄다. 명세환 대표는 ‘기술을 증명하는 시대’를 강조하며 실무적 판단 기준의 중요성을 제시했고, 곽수진 한국자동차연구원 본부장은 AIDV와 피지컬 AI 기반 미래 모빌리티 생태계를 전망했다. 이어 신동주 모빌린트 대표는 피지컬 AI 시대의 핵심 인프라로 엣지 AI 반도체의 역할을 설명했다. 행사 마지막에는 TechDay Contest 2026 시상식과 수상작 발표가 진행되며 실제 기술 구현 사례를 공유하고 산업 현장의 집단지성 생태계 구축 비전을 제시했다. 이번 시상에는 이번 e4ds Tech Day 2026의 플래티넘 스폰서인 마우저 일렉트로닉스(Mouser Electronics)와 ST마이크로일렉트로닉스(STMicro Electronics)가 각각 시상했다. 시상자로는 데프니 티엔(Daphne Tien) 마우저 부사장과 마테오 마라비타 STMicroelectronics APAC AI 역량센터 센터장이 각각 수상자에게 직접 상을 수여했다.
2026.09.09by 배종인 기자