

KETI, 한국 문화유산·한글 특화 AI 모델 ‘HAECHI’ 공개
 기사입력2026.10.01 09:11
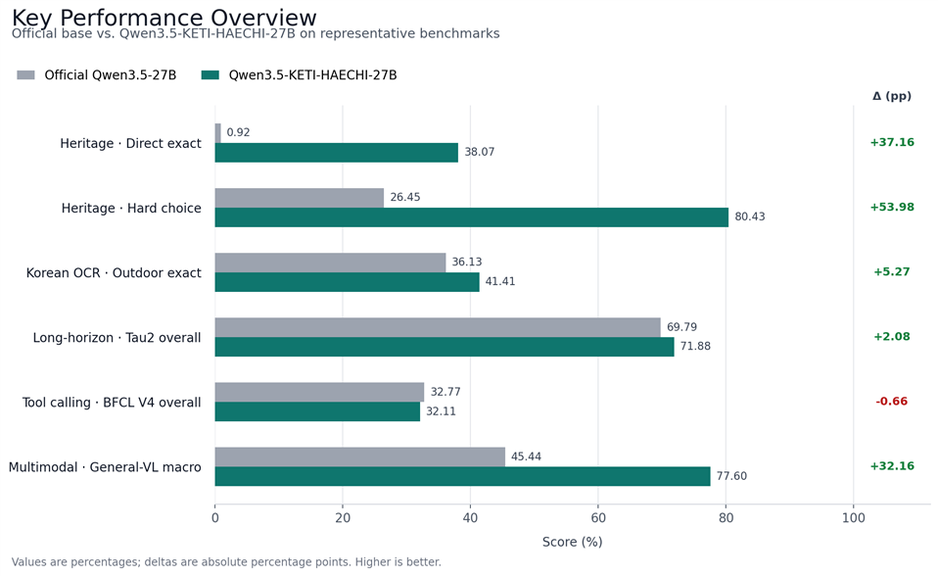
HAECHI는 이미지와 텍스트를 동시에 처리하며, 티켓 발권·상품 구매·환불·서비스 가입처럼 여러 단계를 거치는 작업도 수행할 수 있다.
거리 사진 속 한글 간판 인식 능력도 두 모델 모두 5%포인트 이상 개선됐다.
Qwen3.5 기반 모델은 36.13%에서 41.41%로, HyperCLOVA X 기반 모델은 33.59%에서 38.87%로 올랐다.
앞 단계 작업 결과를 바탕으로 다음 행동을 판단하는 장기 작업 수행 능력 평가(Tau2)에서도 두 모델 모두 약 2%포인트씩 종합 점수가 상승했다.
댓글
관련 뉴스
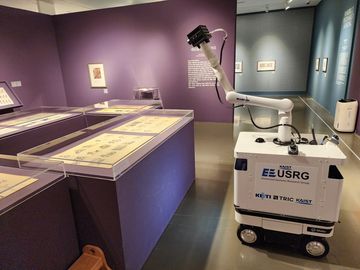
KETI, 텔레프레즌스 로봇으로 소아암 환아에 원격 미술관 체험 제공
KETI가 개발한 로봇-텔레프레즌스 플랫폼을 활용해 소아청소년암 환아들이 병원에서 소마미술관의 전시를 원격으로 관람하는 실증을 완료했다. 실시간 영상 전송, AI 도슨트, 자율주행 기술을 결합한 이 플랫폼은 환아들이 로봇과 카메라를 직접 조작해 전시 작품을 세밀하게 감상할 수 있도록 지원한다. KETI는 향후 이동약자와 도서산간 지역 학생 등 문화시설 방문이 어려운 계층으로 적용 범위를 확대할 계획이다.
2026.08.05by 배종인 기자
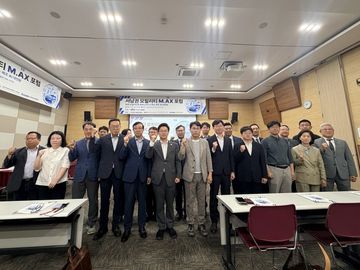
KETI, 서남권 모빌리티 제조AI 전환 거점 구축
한국전자기술연구원(KETI) 광주지역본부가 서남권 자동차·모빌리티 산업의 AI 전환을 주도하기 위해 휴머노이드 실증센터와 자율주행 인지부품 기능안전 시험센터 구축을 연계 추진한다. 의장공정 특화 휴머노이드 투입부터 라이다·카메라·레이더 등 인지부품의 국제 기준 시험·인증까지 전주기 지원 체계를 마련해 지역 완성차·부품기업의 현장 적용을 지원한다.
2026.08.14by 배종인 기자
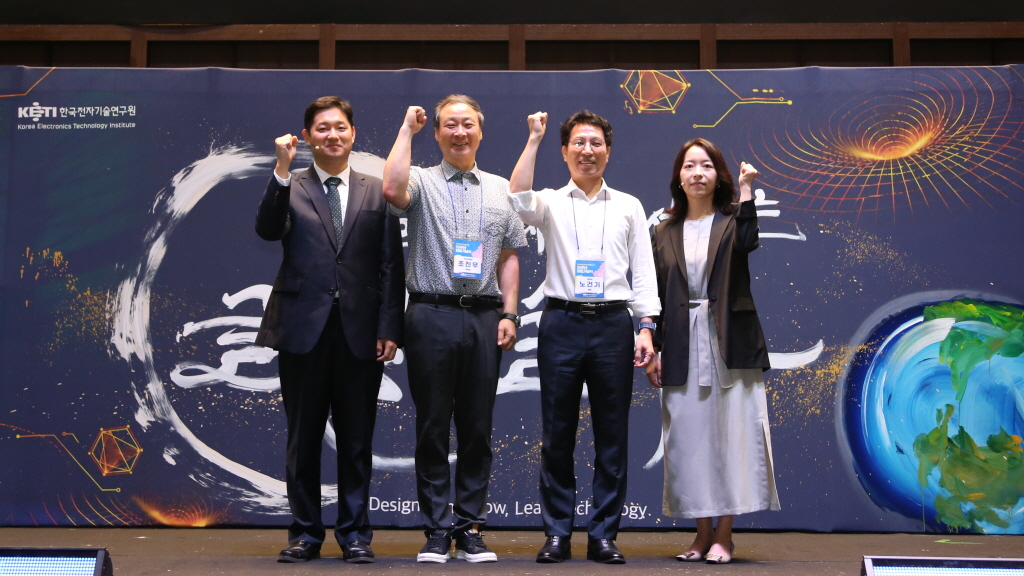
KETI 창립 35주년, ‘글로벌 기술 허브’ 새 비전 선포
한국전자기술연구원(KETI)이 창립 35주년을 맞아 ‘Design Tomorrow, Lead Technology’를 새 비전으로 선포했다. AI 기술 패권 경쟁 심화와 산업 환경 급변에 대응하기 위해 글로벌 연구기관으로의 도약을 목표로 R&D 전략과 국내외 협력을 강화할 계획이다. 전 직원 설문 기반으로 수립된 이번 비전은 35년간 축적한 전자·IT 기술 역량을 토대로 혁신적 기술 개발과 공동연구를 추진한다.
2026.08.24by 배종인 기자
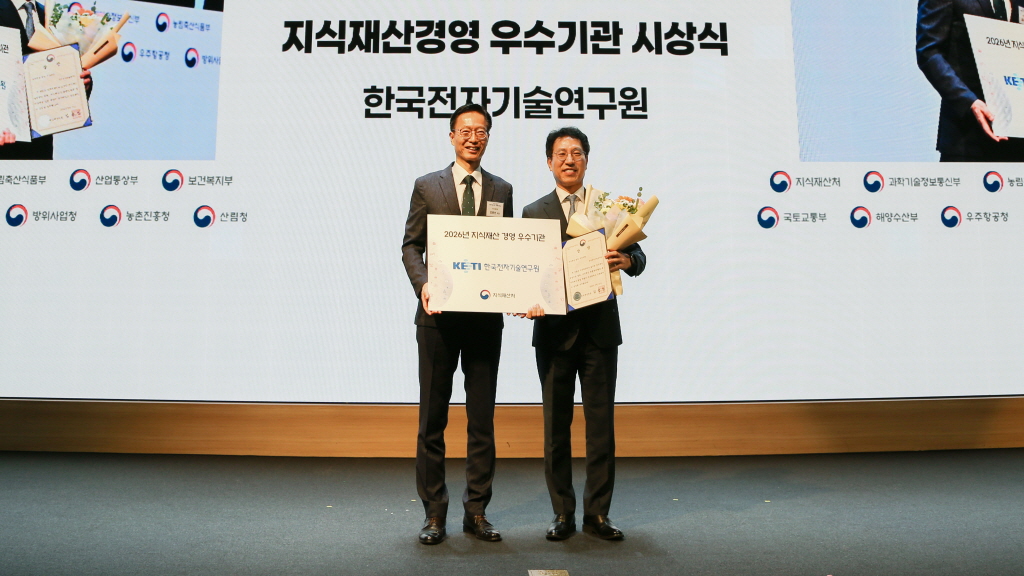
KETI, ‘2026년 지식재산 경영 우수기관’ 선정
한국전자기술연구원(KETI)이 특허 창출·활용 등 지식재산 경영 역량을 인정받아 정부 주관 우수기관으로 선정됐다. 보유특허 진단 부문에서 3년 연속 참여해 등록특허 1,200여 건을 진단했으며, 국제표준특허풀 Via LA와 AVANCI에 특허를 등재하는 성과를 이뤘다. 지난 10년간 등록특허 100%, 해외출원 50% 이상 증가를 달성했으며, 지식재산처로부터 최대 3년간 특허 출원·등록 비용 지원을 받는다.
2026.09.15by 배종인 기자
크레스트, 배터리시스템 열폭주·화재 안전성 시험 합격
배터리시스템 전문기업 크레스트가 KETI 지원과 KCL 협업으로 북미 안전 규격 UL 2271 Edition 3 수준의 열폭주·화재 안전성 시험에 합격했다. 자체 개발한 열폭주 차단 및 열전이 억제 패키징 기술을 적용한 결과 가혹한 시험 조건에서도 화염 확산이 차단되어 최종 합격 판정을 받았다. 하반기 공식 UL 2271 Edition 3 인증 완료를 목표로 국내 AGV·AMR 업체들의 북미 시장 진출 기반을 마련했다.
2026.09.17by 명세환 기자